10月27日,百度发布并开源文心Unlimited OCR 2,实现任意页数文档解析,将OCR的处理上限从数十页推向“无限”。实测显示,该模型能够一次性解析《哈利·波特》全系列7部作品,累计超过3600页,在文档长度大幅增加的情况下,依然保持较高的精度和处理效率,推动文档解析技术迈向OCR 3.0时代。
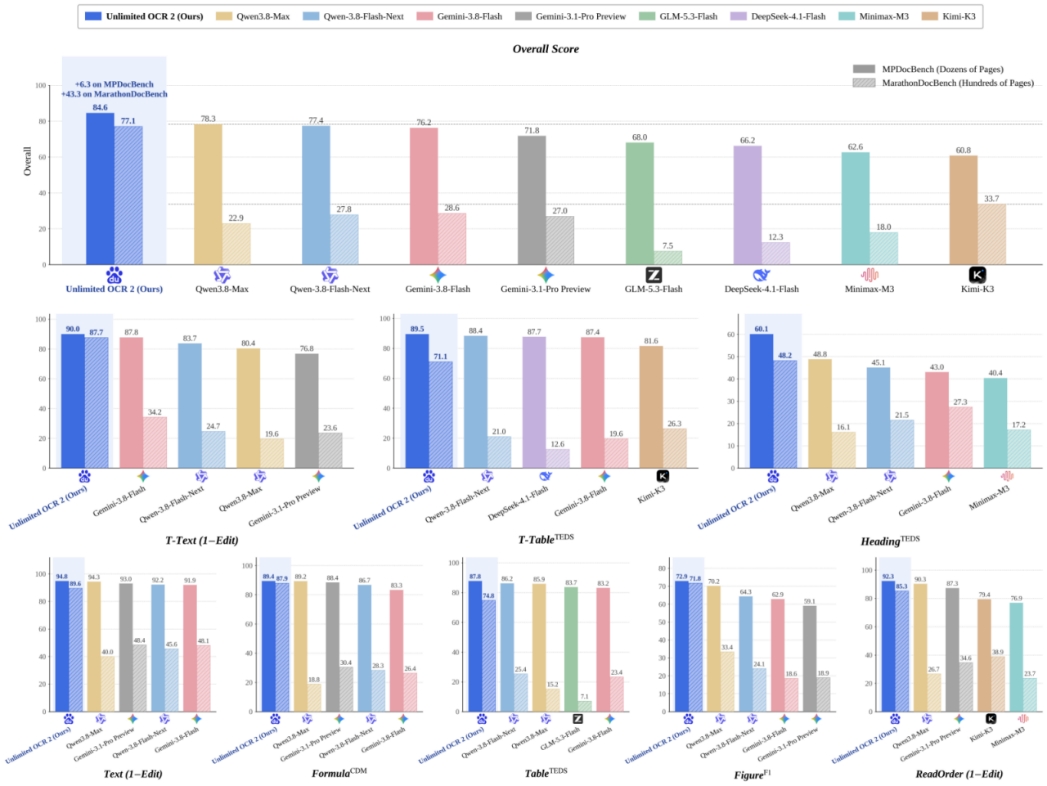
公开基准测试显示,在面向多页文档解析的MPDocBench,以及专门评估百页级超长文档解析能力的MarathonDocBench上,文心Unlimited OCR 2的综合得分分别为84.6分和77.1分,达到端到端性能SOTA,领先Qwen 3.8-Max、Gemini-3.8-Flash、GLM-5.3-Flash、DeepSeek-4.1-Flash等模型。
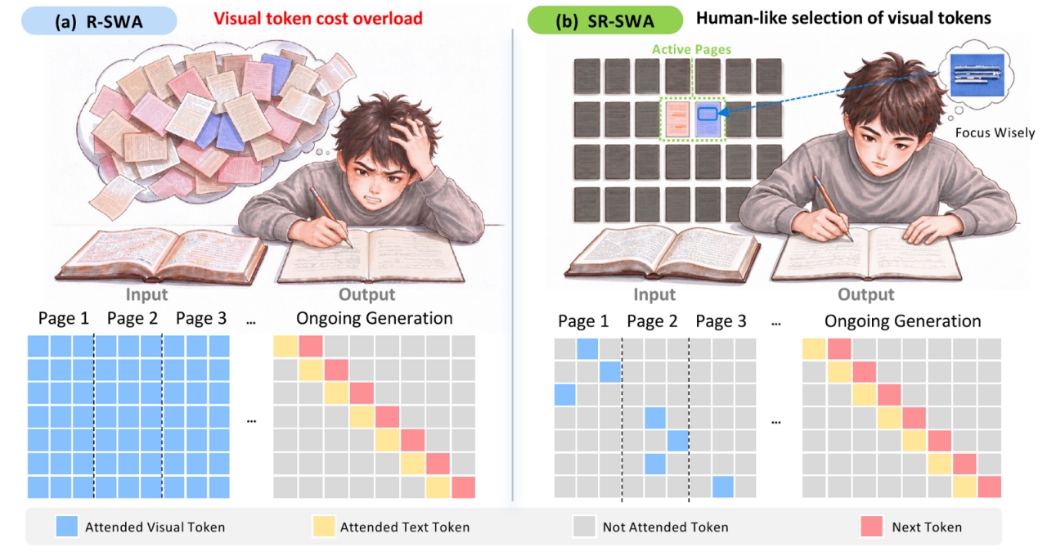
这一突破得益于文心Unlimited OCR 2所提出的稀疏参考滑动窗口注意力机制(Sparse Reference Sliding Window Attention,SR-SWA)。该机制借鉴了人类抄录书籍的过程——通常专注于当前页面,只有在需要核对前文或查找跨页信息时,才会回看相关内容,而非反复翻阅整本书的内容。
SR-SWA将该思路引入模型的注意力计算中。具体而言,页面门控(Page Gate)先把每个查询的视觉参考范围从整个文档缩小到相关页面,同时建模跨页的位置关系;随后引入得分最高的视觉Token桶(Token Buckets),以捕捉长距离视觉依赖关系。报告测试显示,在百页文档场景中,SR-SWA的单步解码速度相比Full Attention和上一代R-SWA分别提升7倍和5.6倍。
随着AI技术的发展,长篇研报、整本书籍等超长文档的解析需求日益增长,对OCR技术提出了全新挑战。传统OCR的解析范围多局限于单页,多页解析通常依赖于结果拼接;第一代Unlimited OCR通过引入参考滑动窗口注意力机制,将解析范围拓展至连续数十页;而此次发布的Unlimited OCR 2则进一步突破了超长文档解析的计算瓶颈,通过SR-SWA减少冗余视觉信息计算,结合无限解码机制(Unlimited-Horizon Decoding)降低超长文档解析的计算与显存开销,推动文档解析技术迈向OCR 3.0时代,实现了真正意义上的任意页数文档解析。
Unlimited OCR项目已经获得全球开源社区广泛认可。第一代Unlimited OCR于6月22日正式发布后,次日即登顶GitHub Daily Trending总榜、Python榜,HuggingFace全球模型总趋势榜、多模态模型趋势榜,GitHub Star 5天突破1万。截至目前,Hugging Face累计下载量突破1000万次,GitHub斩获2.85万Star。
11月12日,百度世界2026大会将进一步展示文心Unlimited OCR 2的技术亮点及应用潜力。本届大会以“下一幕,智能组织”为主题,将发布百度“芯云模体”全栈AI的最新升级成果,助力企业和开发者加速AI应用落地,推动智能组织进化。
目前,文心Unlimited OCR 2的代码和模型权重同步开源至GitHub、Hugging Face,并同步上线百度智能云平台和百度AI开放平台,开发者和企业用户可下载使用。